顏色檢測

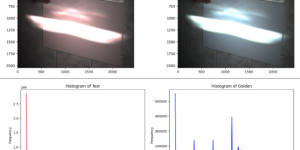
客戶需求∶  我需要檢測車燈的打出來的光的顏色組成,如果超出範圍則發出警示。 檢測手法∶ 色相直方圖分佈∶  影像的色相直方圖分佈是描述影像中不同色相值的統計分佈情況。在色相直方圖中,色相值通常被劃分成若干個區間,例如0到180度之間的若干個小區間。然後,統計圖像中每個區間內像素的數量或者像素的比例,形成一個直方圖。 色相直方圖可以反映出圖像中各個色相的分布情況,即哪些色相在圖像中佔據主導地位,哪些色相較少出現。通過觀察色相直方圖,可以直觀地了解圖像的整體顏色分布情況,以及圖像中具體顏色的特徵。 通常,色相直方圖是基於圖像的色彩空間進行計算的,例如RGB色彩空間或者HSV色彩空間。在HSV色彩空間中,色相(Hue)表示顏色的種類或者色調,因此色相直方圖反映了圖像中不同種類顏色的分布情況。 通過比較不同圖像的色相直方圖分佈,我們可以評估它們之間的顏色相似度或者差異度,從而用於圖像檢索、圖像分類、圖像匹配等領域。 歸一相似度∶ “歸一相似度”(Normalized Similarity)指的是將相似度值歸一化到特定的範圍內,通常是0到1之間。這樣做的目的是使得相似度值更易於理解和比較,不受圖像尺寸、亮度等因素的影響。 在計算兩個直方圖的相似度時,我們可以得到一個原始的相似度值,表示它們之間的相似程度。但是這個值的範圍通常不是固定的,並且可能受到直方圖的大小、圖像的亮度等因素的影響。因此,將這個相似度值歸一化到0到1之間可以消除這些影響,使得相似度更具有可比性。 在歸一化相似度中,常見的做法是使用以下公式: 歸一化相似度=原始相似度直方圖1的總和+直方圖2的總和−原始相似度 歸一化相似度= 直方圖1的總和+直方圖2的總和−原始相似度 原始相似度 ​ 這樣得到的歸一化相似度值會保證在0到1之間,其中1表示完全相同,0表示完全不同。 合格 相似度:0.987 偏紅 相似度:0.552 偏黃 相似度:0.231 偏綠 相似度:0.318 偏藍 相似度:0.239
車燈光型檢測

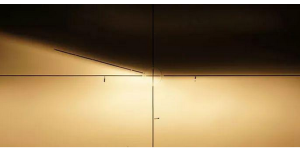
右駕光型量測規範示意 左駕光型量測規範示意 車燈配光室 AOI 輔助車燈燈型量測架設示意圖 使用 High Dynamic Range (HDR) Imaging 技術可以有效解決影像過曝所造成的影像失真問題,並得到一個明暗對比清晰的影像。這可以通過以下步驟實現: AOI 視覺分析 透過HDR技術取得 Tonemap HDR image 及相機反應函數 得到的Tonemap HDR Image, 用於光形的分析,可以得到下列數值 Golden 光型 中心點、輪廓、角度 亮度分佈 測試品  光型 中心點、輪廓、角度 …

Numpy Peak To Peak

NumPy 函式 ptp() 計算陣列沿指定軸的峰值之差(即峰-峰值)。 這是它的功能: 以下是語法: numpy.ptp(a, axis=None, out=None, keepdims=<no value>) 例如: import numpy as np  # 創建一個陣列 x = np.array([[4, 9, 2, 10], [6, 9, 7, 12]])  # x.shape is (2, 4) # 沿著軸 0 計算峰-峰值  result = np.ptp(x, …

線性回歸(Linear Regression)

首先,使用make_regression函數生成了一些合成數據,然後將數據分成訓練集和測試集。接著創建了LinearRegression模型的實例,並使用訓練集對模型進行訓練。訓練完成後,打印出了模型的係數和對新數據的預測結果。最後,通過可視化將訓練集和測試集的散點圖以及線性回歸的平面呈現出來。

密度聚類算法(DBSCAN)

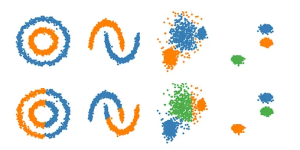
DBSCAN(Density-Based Spatial Clustering of Applications with Noise)是一種密度聚類算法,用於將數據點劃分為多個集群,同時可以識別和排除噪音點。該算法基於以下概念: DBSCAN算法運行步驟如下: DBSCAN的主要優勢是: 總的來說,DBSCAN是一種強大的聚類算法,特別適用於處理具有不同密度和形狀的數據集。

自適應或動態閾值化(Dynamic Threshold)

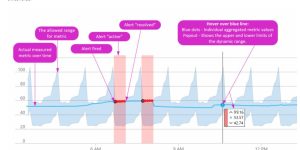
在影像科學中的一個常見應用是將圖像組件從彼此分割開來,這稱為閾值化。傳統的閾值化技術在圖像的背景是平坦的情況下效果很好。不幸的是,這種情況並不常見;相反,圖像中的背景在視覺上會在整個圖像中發生變化。因此,人們開發了自適應閾值化技術,我們可以很容易地在 scikit-image 中使用它們。

稀疏矩陣(SparseMatrices)

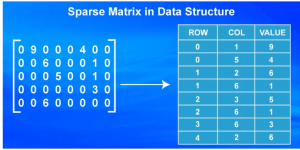
稀疏矩陣相對於密集矩陣在處理大多數元素為零的大型數組時的效率。稀疏矩陣僅存儲非零元素及其位置,導致在某些操作中記憶體使用量和計算時間大幅減少。